
Eine autonome Dokumentenfabrik
Lector übernimmt die Verarbeitung eingehender Dokumente — vollständig, nachvollziehbar und skalierbar. Kein OCR-Tool. Kein Regelwerk. Echtes Dokumentenverständnis.
Was kann Lector?
Mehr als lesen.Verstehen und handeln.
Lector kombiniert Dokumentenverständnis, Kontextanalyse und autonome Verarbeitung und liefert strukturierte Ergebnisse direkt in deine Systeme.
Klassifikation & Trennung
Auf Basis deiner Beschreibung der Dokumentenstruktur.

Nutzung modernster generativer KI-Modelle
Kein Bedarf an Trennblättern oder Stempeln
Zuverlässige Erkennung auch bei Fotos & Handschrift
Posteingang · 6 Seiten
3 Dokumente erkannt
Rechnung · 1 Seite
3 Felder geprüft
Rechnung Rechnungsnr.RE-2026-0815 Datum12.03.2026 IBAN DE00 0000 0000 0000 0000 00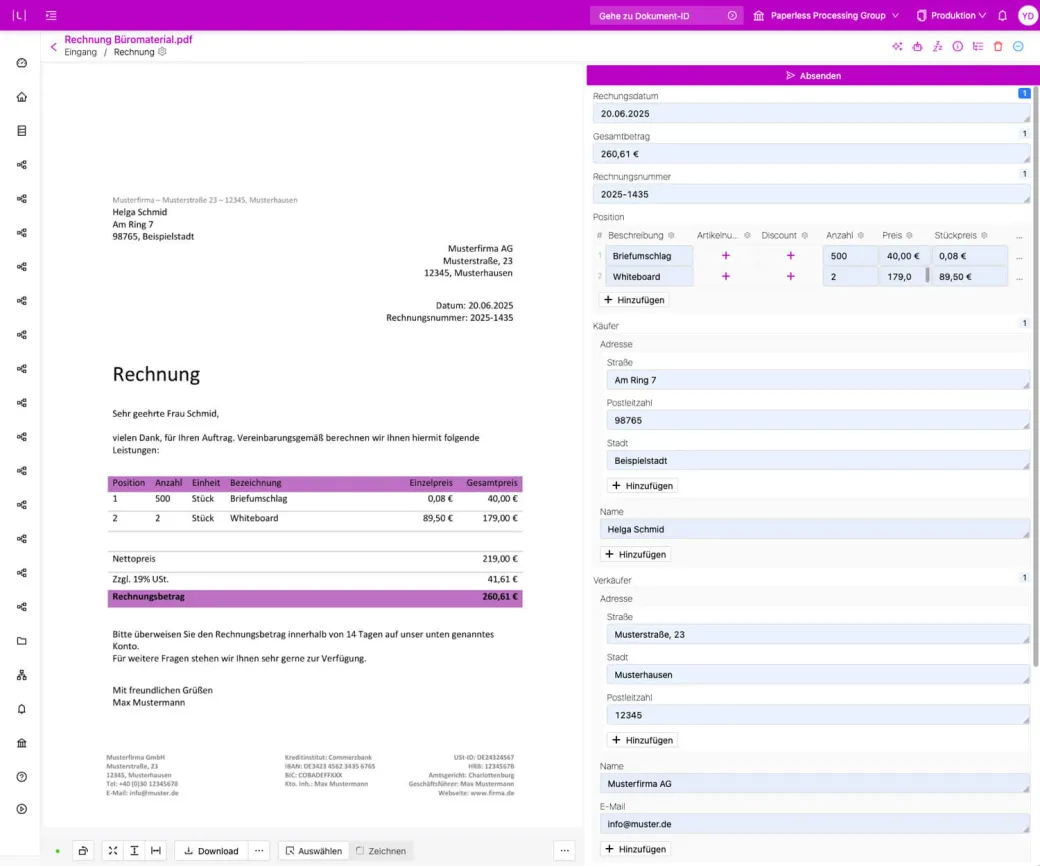
Tiefenauslese
Extraktion relevanter Informationen auf Basis deiner Beschreibung
Präzise Verarbeitung komplexer, unstrukturierter Dokumente
Erkennung auch von handschriftlichen Inhalten
Multimodale Modelle für die Verarbeitung von Text und Bildern
Einfach. Skalierbar. Messbar.

Wie funktioniert lector?
Automatisiere die Bearbeitung vonAufträgen
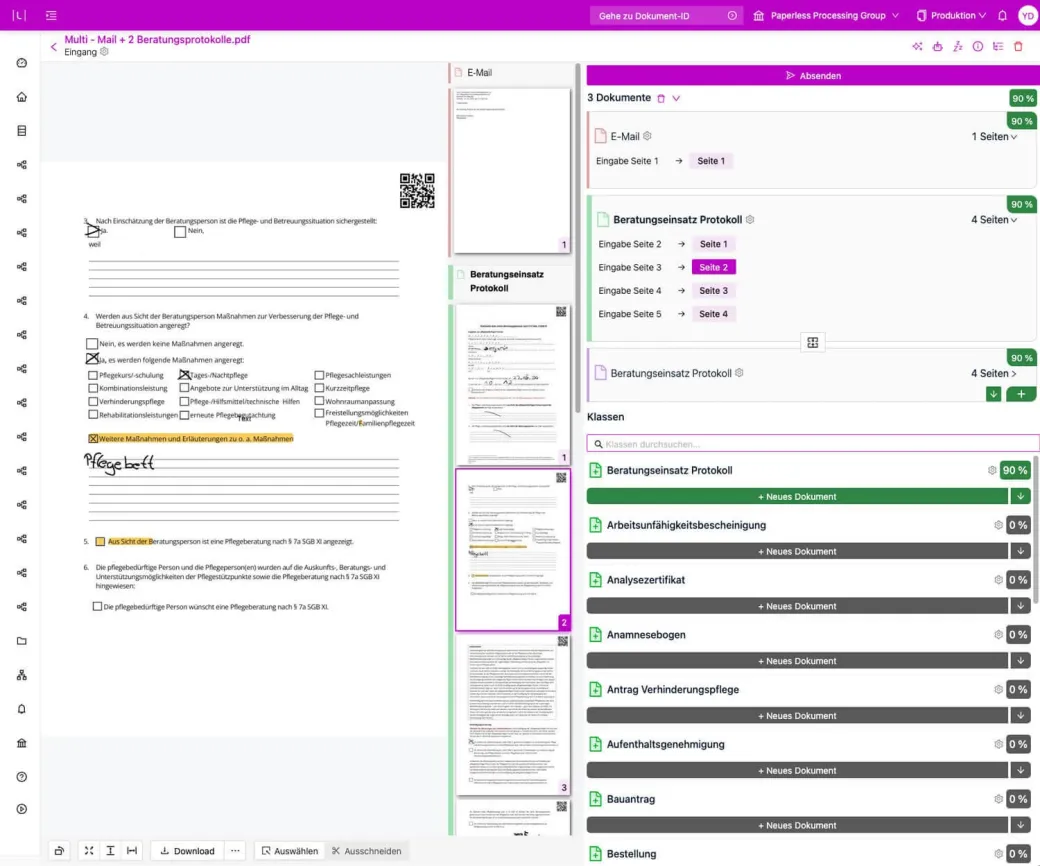
Lector macht aus einem vollen Posteingang einen automatisierten Workflow. Eingehende Mails und Dateien werden klassifiziert, in einzelne Dokumente getrennt und nach Typ sortiert, Leerseiten entfernt und Rotationen korrigiert.
Aus jedem Dokument liest Lector die relevanten Daten aus, inklusive Handschrift und Markierungen. Eingehende Dokumente landen direkt dort, wo sie final hingehören: in Zielsystemen wie CRM, Fachverfahren oder DMS. Du kannst Ergebnisse prüfen oder ab einer selbst gewählten Konfidenz vollautomatisch verarbeiten lassen.
Manuelles Sortieren und Weiterleiten entfällt, und dein Posteingang bleibt tagesaktuell abgearbeitet, statt sich zu stapeln.
Lector prüft eingehende Anträge und Formulare auf Vollständigkeit und Plausibilität, unabhängig von Layout und Dokumententyp. Anhand deiner Prüfkriterien erkennt Lector ausgefüllte und leere Felder, auch bei Handschrift, Ankreuzungen und digitalen Markierungen, meldet, was fehlt, und prüft, ob die Angaben stimmig, logisch und aktuell sind.
Auch erforderliche Anhänge werden kontrolliert, etwa Gehaltsnachweise, Meldebescheinigungen oder unterschriebene Antragsformulare. Fehlende oder unleserliche Unterlagen fallen sofort auf, und eine kompakte Zusammenfassung zeigt Unstimmigkeiten zwischen Dokumenten.
Deine Sachbearbeiter:innen müssen so nicht mehr alle Seiten durchgehen, nur um am Ende festzustellen, dass etwas fehlt. Lector leistet die Vorarbeit, auf deren Grundlage der Antrag schnell bearbeitet werden kann. Die manuelle Prüfung wird so massiv unterstützt, dass nur minimaler Aufwand bleibt.
Lector liest strukturierte, semi- und unstrukturierte Dokumente und extrahiert genau die Informationen, die du brauchst, von Namen und Geburtsdaten über Rechnungsnummern, Beträge und Einzelpositionen bis zu Unterschriften und Checkboxen. Auch Handschrift, optische Markierungen und mehrseitige Dokumente sind kein Problem, ganz ohne OCR-Regeln oder Templates.
Bei bestimmten KI-Modellen siehst du auf Wunsch für jeden Wert, wie sicher sich Lector ist. Statt Daten manuell abzutippen, bleibt so nur die eigentliche Fallbearbeitung, bei hoher Datenqualität und minimaler Nacharbeit.
Lector sortiert und verteilt eingehende E-Mails automatisch, egal ob Bewerbung, Rechnung oder Kundenanfrage. Dabei wertet Lector nicht nur den Mailtext aus, sondern auch die Anhänge und deren Inhalt, und leitet jede Mail an die richtige Person, Abteilung oder das richtige System weiter.
Die Routing-Regeln definierst du selbst, nach Absender, Inhalt, Dokumententyp oder extrahierten Daten. So landet jede Mail ohne manuelles Verteilen dort, wo sie hingehört, und Vorgänge bleiben nicht liegen.
Warum Lector
Lector vs. Chatbots
Ein Chatbot beantwortet Fragen zu Dokumenten.
Lector verarbeitet Dokumente autonom.
| Fähigkeiten | Chatbots |  |
|---|---|---|
| Versteht Dokumente |  |
|
| Beantwortet Fragen zu Dokumenten | |
|
| Extrahiert relevante Daten |  |
|
| Klassifiziert Dokumente automatisch |  |
|
| Validiert Inhalte & Regeln | |
|
| Bearbeitet Vorgänge autonom | |
|
| Übergibt Ergebnisse an Fachverfahren | |
|
| Verarbeitet tausende Dokumente pro Monat | |
|
| Nachvollziehbar & auditierbar | |
|
Selber bauen oder kaufen
Lector vs. selber bauen
Azure Document Intelligence, AWS Textract & Co. sind mächtige Werkzeuge – aber Werkzeuge. Du bekommst Bausteine, kein fertiges Haus. Alles, was aus Bausteinen eine Dokumentenfabrik macht, ist in Lector schon drin.
| Thema | Selber bauen mit Azure, AWS & Co. | |
|---|---|---|
| Modelle & Anbieter | Jeden Anbieter einzeln anbinden; Keys, Rate-Limits, Preise und Modellwechsel selbst verwalten | Multi-Modell-Router: Gemini, GPT, Claude, Mistral, Qwen & Co. über Vertex AI, Azure, OVHcloud und Scaleway – per Klick pro Schritt wählbar, Wechsel ohne Umbau |
| Qualität messen | Testsets, Metriken und Vergleiche von Hand aufsetzen – oder gar nicht | Evaluation-Center: geprüfte Referenz-Datensätze, Metriken je Dokumentklasse, Confusion-Matrizen, Modell- und Einstellungsvergleich auf echten Dokumenten |
| Prompts & Konfiguration | Prompt-Engineering von Hand, Iteration ohne Werkzeug | Konfigurations-Assistent: ein Agent, der Dokumentklassen und Felder aus deiner Beschreibung anlegt und Prompts aus den Korrekturen deiner Sachbearbeiter:innen verbessert |
| Skalierung | Eigene Architektur für Warteschlangen, Parallelität und Autoscaling entwickeln und betreiben | Kafka-basierte Verarbeitung: Kubernetes-Autoscaling, 10.000+ parallele Sessions, Millionen Seiten pro Monat – ohne Umbau |
| Integration in Folgesysteme | Jeden Export und jede Anbindung selbst programmieren und pflegen | Integrationsbibliothek: Webhook und REST-Pull, E-Mail, DMS/ECM (z. B. d.velop, enaio), Fachverfahren per API, Datenbanken, RPA (UiPath, Power Automate) |
| Nachvollziehbarkeit | Logging, Historie und Oberfläche selbst bauen | Audit-Trail: jede Operation an jedem Dokument – Klassifikation, Korrektur, Export – unveränderbar protokolliert, durchsuchbar und exportierbar |
| Dokumenten-Skills | Klassifikation, Trennung, Extraktion und Validierung selbst entwickeln | Fertig eingebaut: Trennung von Sammel-PDFs, Klassifikation, Extraktion, Stammdatenabgleich, Vollständigkeitsprüfung – aus Jahren Projekterfahrung |
| Governance & Compliance | AVV, TOMs, No-Training-Nachweise und Guardrails selbst zusammentragen | Out of the box: DSGVO-konform, EU-Hosting, No-Training-Nachweise je Anbieter, dokumentenspezifische Guardrails, EU-AI-Act-Einordnung |
| Betrieb & Updates | Ein Team, das dranbleibt: Modellwechsel, Refactoring, Monitoring | Übernehmen wir: laufende Updates, Monitoring der System- und KI-Komponenten, auf Wunsch mit SLA |
„Der Markt und die Infrastruktur im Bereich LLMs sind maximal dynamisch. Mit Lector lagern wir das ‚der Technologie hinterherrennen‘ aus.“
IT-Verantwortlicher eines Lector-Kunden